ジャーナル記事
【技術解説】NovelAI による Stable Diffusion の改良
NovelAI Diffusion の画像生成モデルを開発する過程で、Stable Diffusion のモデル構造と学習手法にどのような変更を加えたのかを技術的に解説します。
NovelAI Diffusion の画像生成モデルを開発する過程で、私たちは Stable Diffusion のモデル構造と、その学習手法に手を加えました。
これらの変更によって、生成結果の全体的な品質と使い心地が向上し、画像生成を通じて物語作りを豊かにするという私たちの用途にも、より適したものになりました。
この記事では、実際に行った改良と追加のいくつかについて、技術的な概要をお伝えします。
CLIP の最終層手前の隠れ状態を使う
Stable Diffusion は、CLIP の transformer ベースのテキストエンコーダーから得た最終層の隠れ状態を使い、classifier free guidance によって生成を誘導します。
Imagen(Saharia et al., 2022)では、最終層ではなく、その1つ手前の層の隠れ状態が誘導に使われています。
EleutherAI の Discord での議論でも、最終層手前の層のほうが誘導に適した結果を出す可能性が指摘されていました。最終層では隠れ状態の値が急激に変化し、CLIP ベースの類似度検索でよく使われる、より小さなベクトルへ圧縮するための準備が行われるためです。
実験を進めるなかで、CLIP のテキスト transformer の最終 layer norm を適用しさえすれば、Stable Diffusion は最終層手前の隠れ状態も解釈でき、精度はわずかに落ちるもののプロンプトに沿った画像を生成できることが分かりました。
さらに検証を重ねた結果、私たちは最終層ではなく最終層手前の隠れ状態を使って学習を行うことにしました。そのほうが、タグベースのプロンプトに詰め込まれた密な情報をモデルがうまく活用でき、複数の概念を切り分ける学習も早く進むことが分かったからです。たとえば最終層を使った場合、モデルは異なる概念を分離するのが苦手で、色を正しく割り当てることにも手こずっていました。
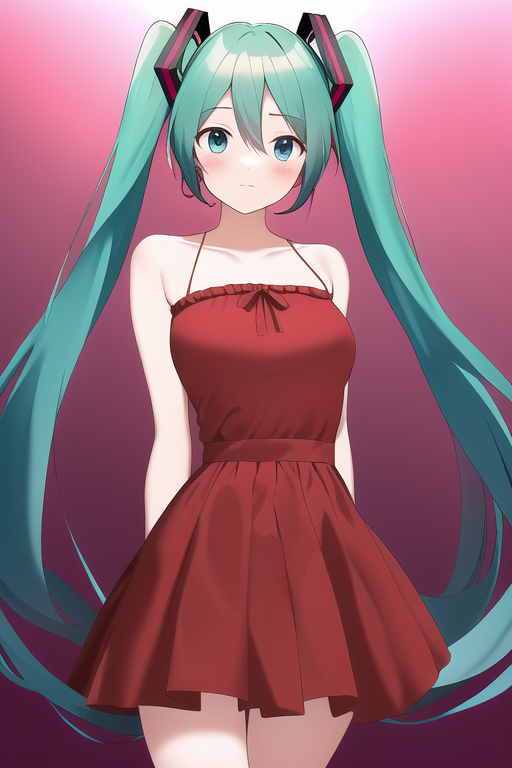
実験段階では、「Hatsune Miku, Red Dress」のようなさまざまなプロンプトを使い、パラメータを変えた学習を評価しました。このプロンプトでは、特に最終層の隠れ状態を使ったとき、学習がある段階に達するまで、ドレスの赤がミクの髪や瞳の色に染み出してしまう傾向がありました。タグ付けされた概念を正確に組み合わせられるかどうかを学習ごとに評価するため、次のようなより複雑なプロンプトも使いました。
`Tags: purple eyes, 1girl, short hair, smile, open mouth, ruffled blouse, red blouse, pleated skirt, blonde hair, green scarf, waving at viewer`
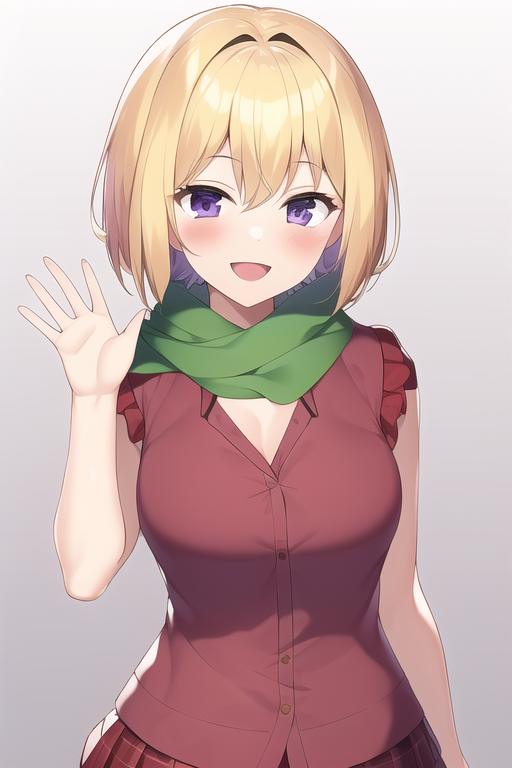
アニメモデル NovelAI Diffusion (Curated) による生成結果。プロンプトは「Tags: purple eyes, 1girl, short hair, smile, open mouth, ruffled blouse, red blouse, pleated skirt, blonde hair, green scarf, waving at viewer」
アスペクト比バケッティング
既存の画像生成モデルによくある問題として、不自然に切り取られた画像が出てきやすいという点が挙げられます。これは、こうしたモデルが正方形の画像を出力するよう学習されていることに起因します。しかし、写真も作品も、そのほとんどは正方形ではありません。加えて、モデルが同時に扱えるのは同じサイズの画像だけであり、学習では GPU の効率を上げるために複数のサンプルをまとめて処理するのが一般的です。その妥協案として正方形が選ばれ、学習時には各画像の中央部分だけを切り出して、モデルに学習例として見せることになります。
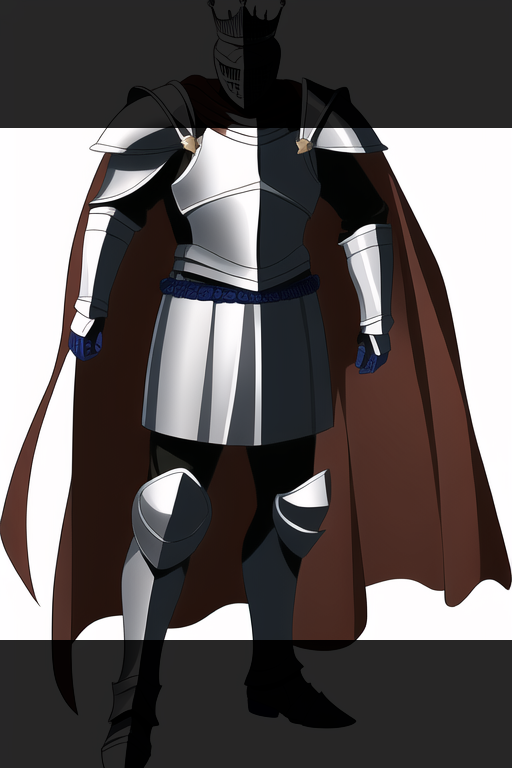
中央切り抜きによって取り除かれる領域を暗くして示した、王冠をかぶった騎士
その結果、人物は足や頭のない状態で生成されがちになり、剣は柄も切っ先も画面の外にある刃だけの姿になってしまいます。
私たちは物語体験に寄り添う画像生成モデルを作っているので、切れていないきちんとした人物を描けることが重要ですし、生成された騎士が無限に伸びる金属質な直線を握っているようでは困ります。
切り抜いた画像で学習させることには、もう一つ、テキストと画像が食い違うという問題もあります。
たとえば `crown` タグの付いた画像は、中央切り抜きを適用した時点で王が首を落とされ、王冠が写っていないことがよくあります。
中央切り抜きの代わりにランダム切り抜きを使っても、これらの問題はわずかしか改善しませんでした。
Stable Diffusion で可変サイズの画像を扱うこと自体は可能です。ただし、512x512 という本来の解像度から大きく離れると同じ要素が繰り返し現れやすくなり、解像度が極端に低いと判別できない画像になってしまうことが確認できます。
とはいえこの結果は、可変サイズの画像でモデルを学習させることは可能だろうという手応えを与えてくれました。サイズがまちまちなサンプルを1枚ずつ学習させるのは簡単ですが、非常に遅いうえ、ミニバッチによる正則化が効かないぶん学習が不安定になりやすくなります。
独自のバッチ生成
この問題に対する既存の解決策が見当たらなかったため、私たちは自前のデータセット向けに独自のバッチ生成コードを実装しました。これにより、1つのバッチ内の要素はすべて同じサイズでありながら、バッチごとに画像サイズが異なるという構成が可能になります。
この仕組みを、私たちはアスペクト比バケッティングと呼んでいます。別のやり方としては、画像サイズを固定し、各画像をその枠に収まるよう拡大縮小したうえで、学習中はマスクされるパディングを加える方法もあります。ただしこれは学習中に無駄な計算を生むため、私たちは採用しませんでした。
以下では、アスペクト比バケッティングのための独自バッチ生成の、もともとの考え方を説明します。
まず、データセットの画像をどのバケットに振り分けるかを定義する必要があります。そのために、最大画像サイズを 512x768、辺の最大長を 1024 と定めます。最大画像サイズが 512x768 で、512x512 より大きく VRAM も多く必要になるため、GPU あたりのバッチサイズは下げざるを得ませんが、これは勾配累積で補えます。
バケットは次のアルゴリズムで生成します。
● 幅を 256 に設定する。
● 幅が 1024 以下である間、以下を繰り返す:
• 高さが 1024 以下、かつ幅 × 高さが 512 * 768 以下となる最大の高さを求める。
• その幅と高さで表される解像度をバケットとして追加する。
• 幅を 64 増やす。
幅と高さを入れ替えて同じ手順を繰り返します。重複したバケットは一覧から取り除き、512x512 のバケットを1つ追加します。
次に、各画像を対応するバケットへ割り当てます。そのためにまず、バケットの解像度を NumPy の配列に格納し、それぞれのアスペクト比を計算します。データセット内の各画像については解像度を取得してアスペクト比を計算し、それをバケットのアスペクト比の配列から差し引きます。こうすることで、差の絶対値をもとに最も近いバケットを効率よく選べます。
`image_bucket = argmin(abs(bucket_aspects — image_aspect))`
画像のバケット番号は、データセット内のアイテム ID と紐づけて保存します。アスペクト比が極端で、最も近いバケットとの差すら大きすぎる画像は、データセットから取り除きます。
学習は複数の GPU で行うため、各エポックの前にデータセットを分割し、各 GPU が同じ大きさの重複しない部分集合を担当するようにします。そのためにまず、データセット内のアイテム ID のリストを複製してシャッフルします。この複製リストの長さが GPU 数 × バッチサイズで割り切れない場合は、割り切れるようになるまで末尾の要素を切り捨てます。
続いて、現在のプロセスのグローバルランクに応じて `1/world_size*bsz` 個のアイテム ID から成る部分集合を選び取ります。以降の独自バッチ生成の説明は、こうしたプロセスのうちの1つから見た視点で、そのプロセスが担当するアイテム ID の部分集合を対象に進めます。
現在のシャードについては、シャッフル済みのアイテム ID を順に見ていき、その画像に割り当てられたバケットに対応するリストへ ID を追加することで、バケットごとのリストを作ります。
すべての画像を処理し終えたら、各バケットのリストを順に確認します。長さがバッチサイズで割り切れない場合は、割り切れるようになるまで末尾の要素を取り除き、それらを別途用意した受け皿バケットへ移します。シャード全体の要素数はバッチサイズで必ず割り切れるので、この操作によって受け皿バケットの長さもバッチサイズで割り切れることが保証されます。
バッチが要求されると、重み付き分布からバケットを1つランダムに選びます。バケットの重みは、そのバケットの大きさを残っている全バケットの大きさの合計で割った値です。こうすることで、大きさが大きく異なるバケットが混在していても、学習中に画像サイズによって登場頻度が偏るような強いバイアスが入らずに済みます。重み付けせずにバケットを選ぶと、小さなバケットは学習の早い段階で空になり、終盤には最も大きなバケットしか残らなくなってしまいます。大きさによる重み付けは、これを避けるためのものです。
最後に、選ばれたバケットからアイテムのバッチを取り出します。取り出したアイテムはバケットから削除され、バケットが空になった場合は、そのエポックの残りのあいだ削除されます。選ばれたアイテム ID と、選ばれたバケットの解像度が画像読み込み関数に渡されます。各アイテム ID の画像が読み込まれ、バケットの解像度に収まるよう処理されます。収める方法は2通り考えられます。
1つ目は、単純に拡大縮小する方法です。この場合、画像がわずかに歪みます。そのため私たちは2つ目の方法を選びました。
アスペクト比を保ったまま、次のいずれかになるように画像を拡大縮小します。
● アスペクト比がちょうど一致する場合は、バケットの解像度にぴったり収まる
● そうでない場合は、片方の辺はぴったり合わせ、もう片方の辺がバケットの解像度をはみ出す
後者の場合には、ランダム切り抜きを適用します。
1枚あたりの平均アスペクト比の誤差はわずか 0.033 だったので、このランダム切り抜きで実際に失われる部分はごくわずかで、たいていは 32 ピクセル未満です。
こうして読み込み・処理された画像が、バッチの画像部分として返されます。
Stable Diffusion のトークン上限を3倍に拡張
もともとの Stable Diffusion モデルでは、プロンプトの最大長は CLIP トークンで 75、これに開始トークンと終了トークンを加えて合計 77 トークンです。これは CLIP 自体にこの制限があり、その CLIP が classifier-free guidance で使うベクトルの生成を担っているためです。
私たちは情報密度の高いタグを扱うため、このトークン上限は簡単に超えてしまいます。そこで、モデルの最大プロンプト長を3倍に拡張しました。
これにより、1つのプロンプトに詰め込める情報量が大きく増え、生成画像を細かく制御できるようになります。
AI ストーリーテラーで紡いだ冒険の文章をそのまま切り出して使うのにも、うってつけです。
具体的には、バッチ内のプロンプトの最大長を求め、それを 75 の倍数へ切り上げます。バッチ内の短いプロンプトは、CLIP の文末トークンで最長のプロンプトと同じ長さまで埋められます。合計長が私たちの定めた上限である 225 トークンを超える場合は、バッチをシーケンス方向に 225 まで切り詰めます。その後、シーケンス方向に 75 トークンずつのかたまりへ分割し、各かたまりを個別に CLIP のテキストエンコーダーへ通します。こうして得られたエンコード済みのかたまりを、最後に連結します。
classifier-free guidance では `uc + (uc — prompt) * scale` という形で無条件条件付け(UC)とプロンプトの条件付けが足し合わされるため、推論時には UC をプロンプトと同じ長さまで埋めておく配慮が別途必要になります。
初期の実験では、素の Stable Diffusion モデルでも、この形式で与えられたプロンプトの追加情報をある程度は活用できることが確認できました。性能を最大限に引き出すため、学習時にはプロンプトの長さを 75 トークン未満から 225 トークンまで変化させ、さまざまな長さのプロンプトにモデルが理想的に適応できるようにしています。
Hypernetwork
2021年、Kurumuz はモデルの生成を制御する新しい手法として Hypernetwork の開発に着手しました。
狙いは、当時 prompt tuning に基づいていた NovelAI のテキスト生成用モジュールを、より優れたものにすることでした。
なお、この概念は2016年に Ha らが発表した HyperNetworks とはまったく別物です。あちらはモデルの重みを変更したり生成したりする手法ですが、私たちの Hypernetwork は、より大きなネットワークの複数の箇所に小さなニューラルネットワーク(線形層または多層パーセプトロン)を1つ適用し、隠れ状態を変化させるものです。
開発を進めるなかで、対象モデルの異なる箇所に1つあるいは複数のネットワークを適用するなど、数多くの Hypernetwork の構成を試しました。初期段階の実験の多くは、テキスト生成用の大規模 transformer モデルで行われました。
これらの実験の成果は、将来の AI Modules V2 につながっていきます。
小規模での初期検証はきわめて有望な結果を示しており、従来の prompt tune よりもはるかに強くモデルの挙動に影響を与えるモジュールを作れることが分かりました。これを受けて、新しい Hypernetwork の構造だからこそ可能になる各種モジュール向けのデータセットの作成と最適化が進んでいます。
この技術で重要になるのが処理性能です。複雑な構造ほど学習後の精度は高くなり得ますが、推論の遅さが本番環境では大きな問題になり、品質向上の意味がなくなってしまう地点があります。そこまで来ると、Hypernetwork を使わないより大きなモデルのほうが、速度でも結果でも上回ってしまいます。
Stable Diffusion がリリースされる前の開発初期、私たちは研究目的でモデルへのアクセスを得ていました。その期間、研究チームはあらゆる角度からモデルを掘り下げ、どう改良できるかを探りました。私たちのサービスにうまく馴染みそうなものの一つがモジュールでした。テキスト生成サービスですでにおなじみの概念であり、モデルの出力を前例のないレベルで制御できるからです。当初は、テキスト生成のモジュールと同じように embedding を学習させる方法を試しました(この手法は textual inversion でも同様に使われています)。
しかし、学習させた embedding ではモデルが十分に汎化できず、学習容量もその embedding に縛られてごく小さいままでした。そこで、私たちの Hypernetwork の技術を Stable Diffusion に適用してみようと考えました。うまくいけば、本番環境で使えるだけの処理性能を保ちつつ、学習容量をずっと大きくできるはずだったからです。
数多くの構造を試して何度も反復した末に、Aero が、処理性能に優れ、なおかつデータセットの大小を問わず高い精度を出せる構造を編み出しました。この Hypernetwork は Stable Diffusion の CrossAttention 層の k ベクトルと v ベクトルに適用され、U-net の他の部分には一切手を触れません。この手法では浅い attention 層が早々に過学習してしまうことが分かったので、学習時にはそれらの層にペナルティをかけています。これで過学習の問題はおおむね抑えられ、学習終了時の汎化性能も向上しました。
この構造は、場合によってはファインチューニングと同等か、それ以上の性能を発揮することが分かりました。
とりわけ、対象とする概念のデータが限られている場合には、ファインチューニングよりも良い結果になります。これは、元のモデルがそのまま保たれ、Hypernetwork が潜在空間の疎な領域を見つけてデータに合わせられるためだと考えています。一方、同じように小さなデータセットでファインチューニングを行うと、わずかな学習例に合わせようとするあまり、モデルは汎化能力を失ってしまいます。
以上です。
この3か月で見えてきた開発の深いところを、楽しんで読んでいただけたなら幸いです。NovelAI Diffusion での生成を存分にお楽しみください。