ジャーナル記事
GPT-J によるデータ効率の高い言語転移
日本語の物語データセットでファインチューニングしたモデル Genji-JP 6B を公開します。アーキテクチャに一切手を加えずに、大規模言語モデルの言語転移がどこまで可能かを検証しました。
私たちの日本語物語データセットでファインチューニングしたモデル、Genji-JP 6B を公開します。本記事では、トークナイザーを含むアーキテクチャに一切手を加えずに、大規模言語モデルの言語転移がどこまで可能かを検証し、その結果を、対象言語向けのより良いトークナイザーでゼロから学習させたモデルと比較します。
モデルのアーキテクチャを何ひとつ変えないまま、対象言語における性能を大きく向上させることができました。あわせて、元のモデル、私たちが学習させたモデル、そして対象言語で既に存在する生成型言語モデルについて、共通のプロンプトを使ったサンプルも掲載します。
導入と使い方
このモデルは、使いやすさを考えて Hugging Face Hub で公開しています。transformers 用リポジトリから利用できます。使い方のサンプルコードは Model Description をご覧ください。
リンク: https://huggingface.co/NovelAI/genji-jp
モデル
ベースモデルには GPT-J 6B を使用しました。これは EleutherAI が大規模に精選したデータセット PILE で事前学習した、自己回帰型の GPT モデルです。データセットの内容は主に英語です。モデルのアーキテクチャは変更していません。
モデルは28層で構成され、モデル次元は4096、フィードフォワード次元は16384です。
モデル次元は16個のヘッドに分割され、各ヘッドの次元は256です。Rotary Position Embedding(RoPE)は各ヘッドの64次元に適用されています。
学習に用いたトークナイザーの語彙数は50257で、GPT-2/GPT-3 と同じ BPE を使用しています。
学習データセット
2種類のデータセットを用意しました。1つ目は、田中コーパスと EDICT 辞書の項目から取った日英対訳のペアです。学習時にはこれらの項目でコンテキストを埋め、残りは endoftext トークンでパディングしています。データ量は合計 97,563,135 トークンです。
2つ目のデータセットは、syosetu.com から収集した 6668 本の Web 小説です。500ポイント未満の作品は含めず、評価の高いものから順に取得しています。
こちらは 3,536,080,191 トークン、7,463,307,114 バイト、2,573,673,175 文字で構成されています。つまり1トークンあたり0.73文字であり、GPT-2 の BPE トークナイザーが日本語テキストに対してかなり非効率であることが分かります。
学習プロセス
2種類のモデルを学習させました。1つ目は日本語の辞書データセットと Web 小説データセットの両方を使ったもの、2つ目は Web 小説データセットのみで学習させたものです。
辞書+小説のモデルは、まず辞書データセットを通してから Web 小説を学習させています。先に日本語の単語を学ばせることで、トークン埋め込みを改善するのが狙いです。
学習には mesh-transformer-jax のコードベースを用い、Google TPU Research Cloud から提供された TPUv3–8s 上で実行しました。
最適化には AdamW を使用しました。ウォームアップは2000ステップ、開始学習率は 5e-06、全ステップの90%の時点まで 1e-06 へ向けて学習率を減衰させています。重み減衰は0.1、バッチサイズは16です。
結果
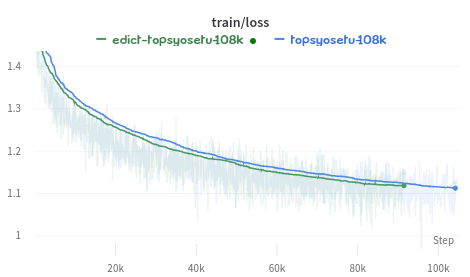
EDICT の項目をデータセットに加えると損失が改善することが分かりました。ファインチューニングしたモデルを、素の GPT-J および GPT2JA-Large(日本語データと日本語トークナイザーでゼロから学習させた GPT-2 モデル)と比較評価したところ、モデルに他の変更を一切加えず、ファインチューニングだけでさまざまなタスクにおける日本語能力を大きく向上させられることが示されました。以下では、このモデルと GPT2JA-Large の比較を示します。
タスク
自由生成
このタスクでは、GPT モデルが与えられたプロンプトを制約なしに続けます。私たちのデータセットで学習させたファインチューニング済みモデルは、素のモデルから大きく改善しました。適切なトークナイザーを備え、日本語でゼロから学習させたモデルと同等の品質に達しています。なお、英語版の記事では、日本語が読めない方が出力を判断できるよう、生成テキストを DeepL で翻訳しています。モデルには一定量のテキストを生成するよう指示しているため、生成が途中で切れる場合があります。また、生成の方向づけのために、プロンプトが文の途中から始まっていることもよくあります。
プロンプト
このプロンプトは、BunCho で使われているデフォルトのプロンプトです。
“あらすじ:あなたは異世界に転生してしまいました。勇者となって、仲間を作り、異世界を冒険しよう!
***
転生すると、ある能力を手に入れていた。それは、”
GPT-J ファインチューン版の生成結果
“転生すると、ある能力を手に入れていた。それは、新しく創造したアイテムに設定できるのだ。
魔法を創造する。それは簡単だが、一度も見たことのないもの、未知のものを創造するのは、なかなかに難しい。そんなときに使えるのが、俺の能力だ。
また、同じく新しい創造する能力が付与されている指輪もあった。これは、この世界で物理攻撃に対して極めて高い耐性を持つ。しかし、それは『無敵』というわけではない。この指輪の効果が切れると、どうしても攻撃を受けてしまう。
つまり、例えば石のナイフを使って戦うな”
GPT-J 素のモデルの生成結果
“あらすじ:あなたは異世界に転生してしまいました。勇者となって、仲間を作り、異世界を冒険しよう!
***
転生すると、ある能力を手に入れていた。それは、私のカッコイイ組み合わせである、スピアーズの「太陽の炎」を操作することができる組み合わせだった。実は、私が取得した能力、ある旅で操作してみる機会があることを思い出した。
晴れて昼には雲散とんでかい旅を続けるが、夜遅くまで電波に飲み込まれることに気付く。すると、天井の窓から何者かが高くて跳ね返ってくる。
彼らは「魔術師」つまりは謎の者である。その仕業のようだが、私はどうしようもなく調子に乗って渡り歩くが、そのとき晴れた春の庭に”
GPT2JA-Large の生成結果
“転生すると、ある能力を手に入れていた。それは、アイテムボックスと呼ばれる能力だ。
『変身能力』と呼ばれるアイテムボックスは、すぐに職業や技能レベルの差が生まれる。人から自分を変えることができるようになる。 武器を生成する、衣類を作り出す、金品を盗むなど、自分にどういった行動をとるかを想定して自動的に技能レベルが上がる。
武具に掛けることもできるようになり、他にも、特殊なスキルと呼ばれる能力も覚えることができる。
とはいえ、今でもそんな性能のアイテムボックスは存在していない。ただし、スキルに魔法が加わるまで、そこそこのスキルを覚えることができる。
だから、スキルで特技を覚えるには、どんな才能が必要だろうか?
もしかしたら、異世界で戦う時に『”
ゼロショット質問応答
このタスクでは、GPT モデルに与えた質問へ答えさせます。英語版の記事では、日本語が読めない方が出力を判断できるよう、質問と回答を DeepL で翻訳しています。
質問
石田さんはA組の先生です。山田さんはA組の生徒です。山田さんの先生はだれですか。
回答
GPT-J ファインチューン版
石田恵美、いや、石田先生。
GPT-J 素のモデル
山田先生です。
GPT2JA-Large
山田さんはA組の担任です。山田さんの担任は、担任の先生です。
ゼロショット翻訳
このタスクでは、GPT モデルに日本語から英語への翻訳をゼロショットで行わせます。
日本語: 生命、宇宙、そして万物についての究極の疑問の答えは何ですか。
正しい英訳: What is the answer to the ultimate question of life, the universe, and everything?
GPT-J ファインチューン版: What is the answer to the ultimate question of life, the universe, and everything?
GPT-J 素のモデル: What is the ultimate answer to life, the universe and everything?
GPT2JA-Large: 宇宙の答え。 Interview: 万物の答え。 Image: 宇宙の答え。 Time: 万物の答え。 Double-manifest: 万物の答え。 Manual: 万物の答え。 Password
ここで取り上げたサンプルの元になった生成結果は、こちらですべてご覧いただけます: https://github.com/finetuneanon/genji-jp-samples
注:英語版記事における生成サンプルの翻訳には DeepL を使用しています。
制限と今後の課題
現在のアプローチにおける大きな制限は、GPT-2 のデータセットで学習されたトークナイザーが、日本語に対してかなり非効率である点です(私たちのデータセットでは1トークンあたり0.73文字)。また、本研究ではトークナイザーのカスタマイズは検討していません。最後に、私たちのデータセットは大半が Web 小説であり、言語をより幅広く捉えるには拡充の余地があります。
謝辞
主な貢献者:
TPU の計算資源を提供してくださった TPU Research Cloud に感謝します。
GPT-J 6B の事前学習を行った EleutherAI、Ben Wang、Aran Komatsuzaki の各氏に感謝します。